Как сделать ИИ-агента самоулучшающимся: пример для статей и Telegram
Что такое RSI и как улучшать skill для статей и постов с помощью ИИ-агента: проверки, обратная связь и автоматизация.
Содержание
Вы уже пишете с помощью ИИ-агента. У него есть skill — файл с инструкцией и, при необходимости, сопутствующими материалами. Благодаря ему агент знает, как искать источники, готовить статью и делать пост для Telegram. Но время от времени вы исправляете одни и те же ошибки: убираете неподтверждённые утверждения, просите добавить пример или переписываете слишком общее вступление.
Можно ли сделать так, чтобы агент замечал такие ошибки сам и следующие тексты становились лучше?
Можно построить процесс, в котором агент проверяет каждый материал, сохраняет результаты, предлагает изменения в своём skill и испытывает их на других задачах. Часть этого цикла способна работать без вашего участия. Но сначала нужно определить, что считать улучшением и откуда агент узнает о результате.
Разберём, что такое RSI, чем самоулучшение отличается от обычной самопроверки и как настроить первый цикл для существующего skill в Codex или Claude Code. Пример условный: он показывает принцип работы, а не результаты проведённого эксперимента.
Что такое RSI простыми словами
RSI расшифровывается как recursive self-improvement — рекурсивное самоулучшение. Идея в том, что ИИ участвует в создании более способной версии системы, а затем улучшенная версия помогает создавать следующие улучшения.
В самом широком смысле обсуждают ситуацию, когда ИИ самостоятельно разрабатывает всё более сильные модели-преемники. Это исследовательская цель: по оценке Anthropic, полностью автономное создание собственного преемника пока не достигнуто.
Для повседневной работы полезен более узкий подход. Языковая модель может оставаться прежней, а агент улучшает то, как она работает с вашей задачей: инструкцию, примеры, инструменты, порядок поиска или проверок. Эту конструкцию вокруг модели иногда называют обвязкой агента.
Допустим, ваш skill говорит: «Напиши пост по источнику». Агент несколько раз делает выводы, которых в источнике нет. Изучив ошибки, он предлагает добавить в skill правило: «Перед написанием проверь каждое существенное утверждение по источнику; если подтверждения нет, убери его или отметь неопределённость». Новое правило проверяют на других постах и, если оно действительно помогает, сохраняют для следующих запусков.
Это самоулучшение на уровне процесса. Строго доказать более сильное RSI — когда каждая версия ещё и лучше создаёт следующие версии — сложнее: способность к дальнейшему улучшению нужно измерять отдельно.
Чем самоулучшение отличается от самопроверки
Эти механизмы полезно разделить, потому что решают они разные задачи.
Самопроверка текущего текста. Агент написал пост, нашёл слабое начало и переписал его. Улучшился конкретный пост, но следующий может содержать ту же ошибку: опыт не обязательно сохранился.
Память об ошибках. Агент записал: «Я часто добавляю вывод без подтверждения». Он сможет учесть это позже, если действительно прочитает запись. Но запись пока не доказывает, что будущие тексты стали лучше.
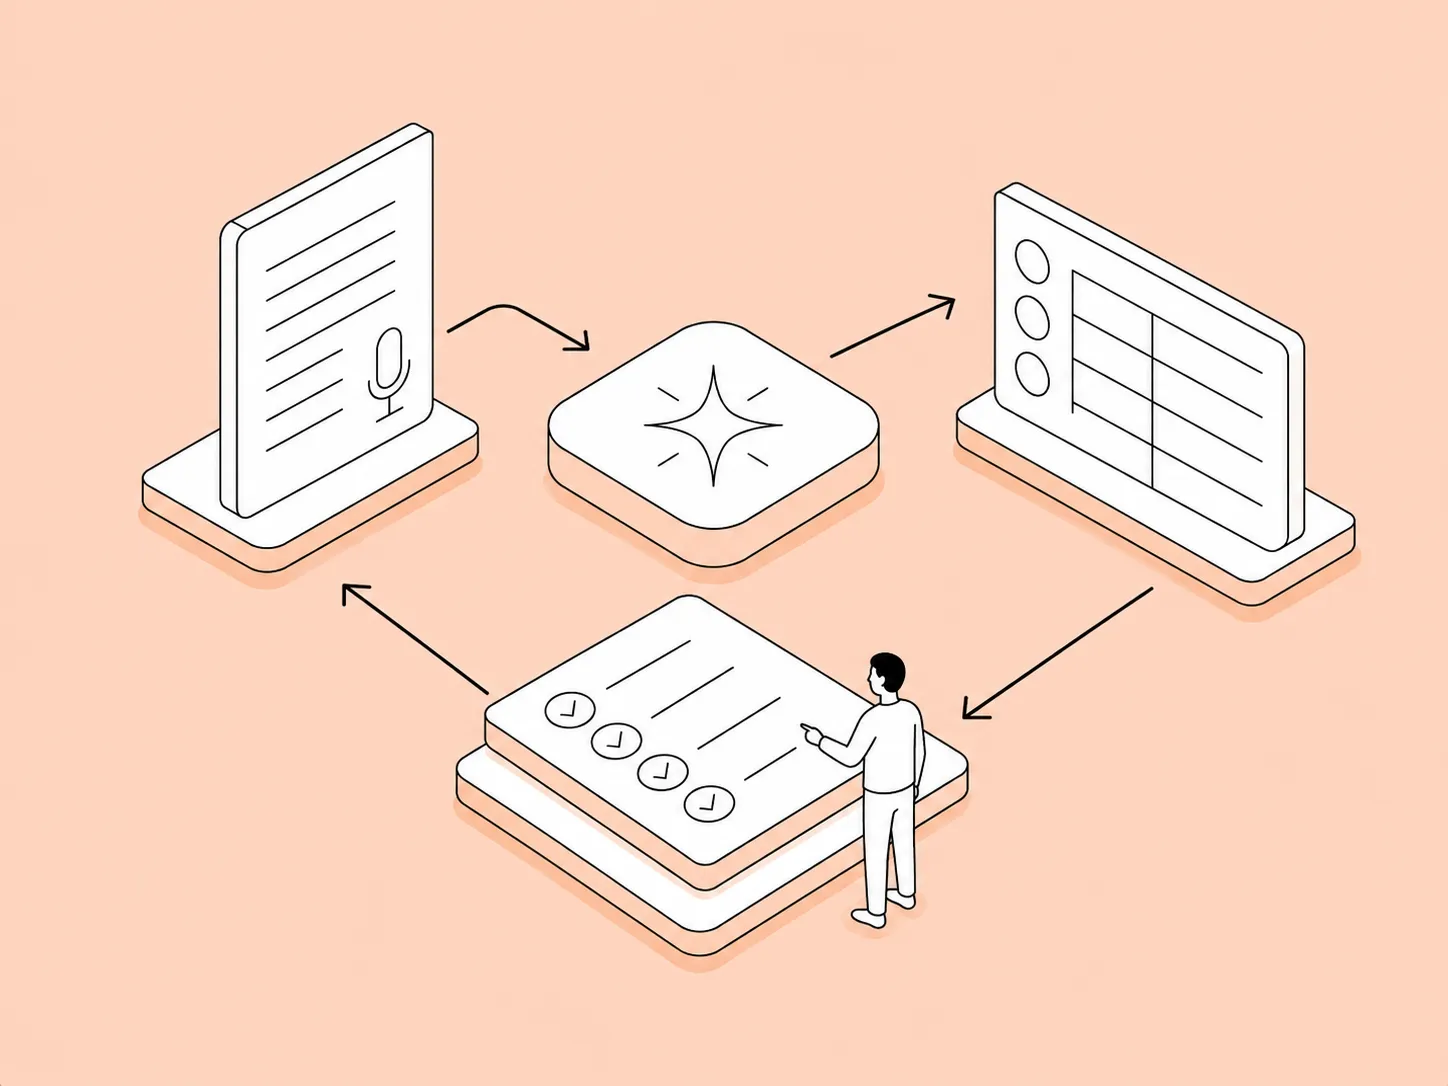
Улучшение процесса. Агент сопоставил несколько ошибок, предложил изменить skill, проверил новую инструкцию и сохранил подходящую версию. Следующие тексты теперь проходят обновлённый процесс.
Последний вариант и нужен, если цель — улучшаться от материала к материалу, а не только вычитывать каждый черновик заново.
Из чего состоит работающий цикл
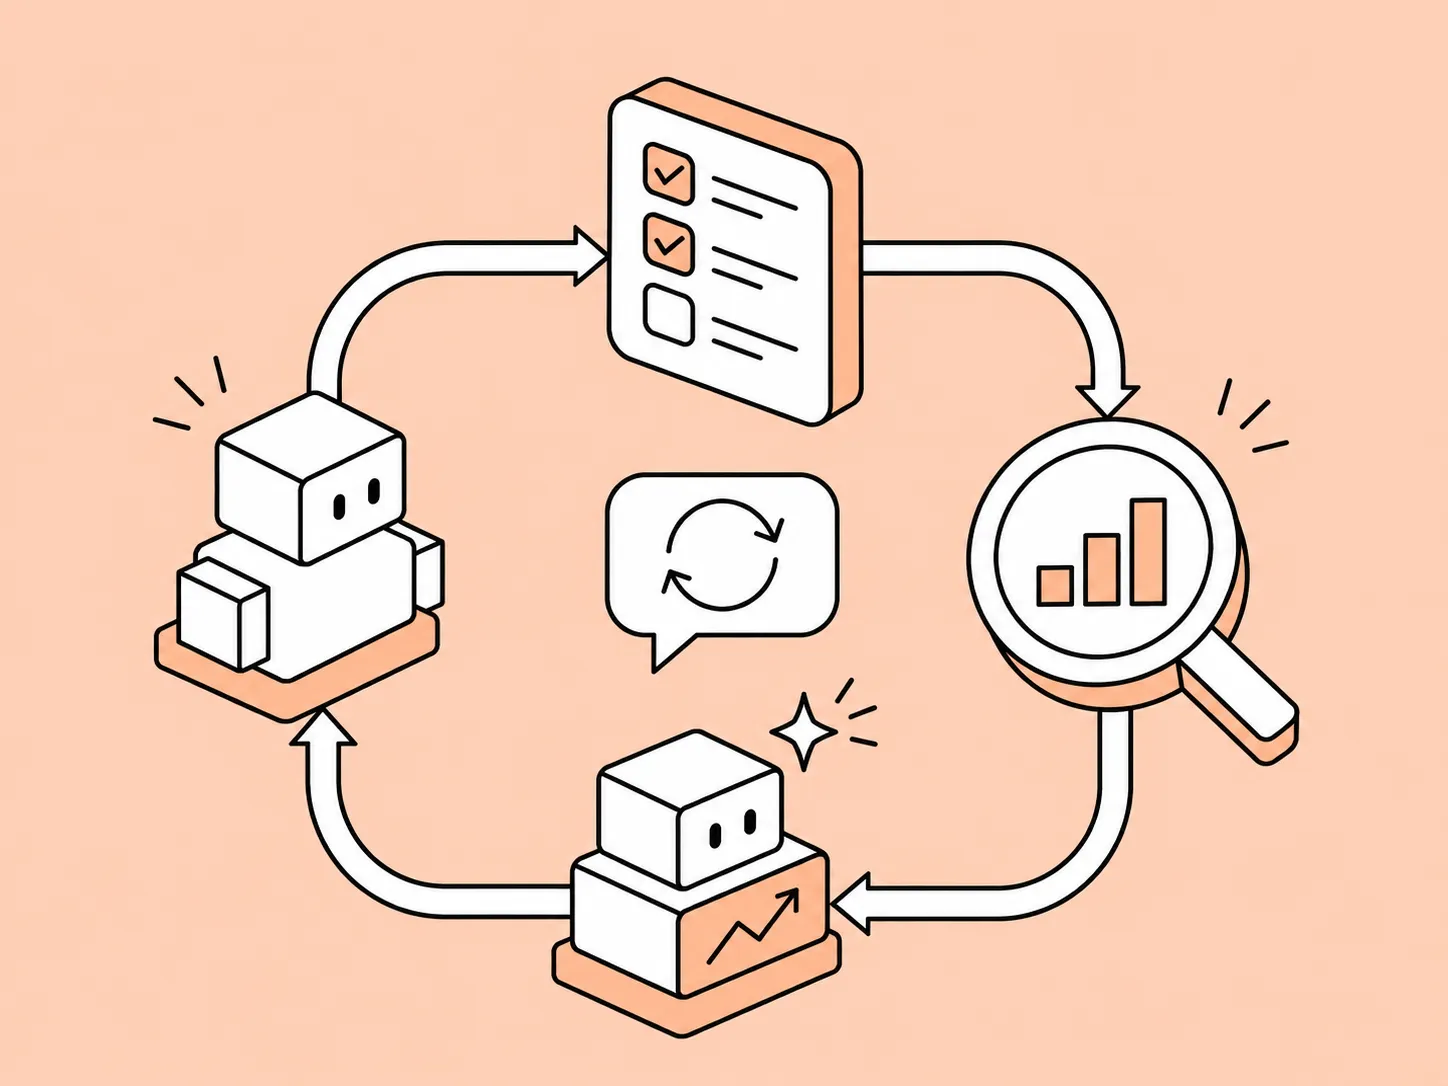
Для примера представим контент-агента, который готовит посты по новостям. У него есть четыре действия:
- Написать. Агент использует ваш действующий skill и готовит черновик.
- Проверить. Отдельный запуск агента оценивает текст по понятным критериям и указывает конкретные ошибки. Где возможно, подключаются обычные проверки: например, наличие ссылок или обязательных полей.
- Запомнить. Система сохраняет черновик, замечания, исправленную версию и, когда они доступны, ваши правки или результаты публикации.
- Улучшить skill. Периодически агент ищет повторяющуюся проблему, предлагает небольшое изменение и сравнивает старую и новую инструкции на других заданиях.
Skill → черновик → проверка → правки → результат
  ↑                                      ↓
  └── проверенное улучшение ← повторяющиеся ошибки
Первые три действия могут выполняться для каждого материала. Четвёртое лучше запускать после накопления нескольких примеров: иначе агент рискует превратить частную особенность одного текста в общее правило.
Проверяющий агент полезен, но он тоже может ошибаться и соглашаться с автором по неверным основаниям. Отдельный запуск уменьшает влияние контекста черновика, однако сам по себе не гарантирует независимой или правильной оценки. Для фактов нужны источники, для реакции аудитории — данные после публикации, а для важных выводов полезна выборочная проверка человеком.
Когда стоит использовать такой подход
Самоулучшение особенно полезно, если задача повторяется и ошибки можно распознать:
- агент регулярно пишет статьи или посты в одном стиле;
- готовит рассылки, а команда фиксирует качество ответов и отказы;
- создаёт ответы поддержки, которые сотрудники редактируют;
- собирает отчёты по одинаковым критериям и получает исправления аналитика.
Если вы готовите один текст в месяц, сложная система проверок может стоить больше времени, чем ручная редактура. Если материалов много, а ошибки повторяются, даже один удачный новый шаг проверки может сэкономить работу на следующих выпусках. Размер эффекта нужно измерить на своей практике.
Для контента есть несколько разных целей. Можно уменьшать число неподтверждённых фактов, сокращать время редактора или улучшать реакцию читателей. Лучше начинать с одной цели: иначе будет трудно понять, помогло ли новое правило. Просмотры и реакции полезны, но на них влияют тема, время публикации и размер аудитории. Больше просмотров не всегда означает более полезный или точный текст.
Простой пример: улучшаем существующий skill
Предположим, у вас уже есть skill, который пишет Telegram-посты. Не нужно создавать нового агента с нуля. Достаточно добавить к существующему процессу проверку, журнал ошибок и периодическое улучшение инструкции.
В Codex проектный skill может лежать в .codex/skills/<имя>/SKILL.md, в Claude Code — в .claude/skills/<имя>/SKILL.md. Точное расположение зависит от того, как и где вы установили свой skill; сначала попросите агента найти именно тот, которым вы пользуетесь. Подробнее: skills в Codex и skills в Claude Code.
Ниже три шага. Их можно поручить и Codex, и Claude Code. Названия файлов в примере — удобный вариант хранения, а не обязательное устройство инструментов.
Шаг 1. Добавьте проверку каждого поста
Откройте проект с вашим skill и дайте агенту такую задачу:
Найди мой skill, который готовит посты для Telegram.
Прочитай его и предложи изменение: после подготовки поста
нужно проверять, что все существенные факты подтверждены
источником и в тексте есть понятный вывод для читателя.

Пусть проверка указывает конкретный фрагмент, проблему
и способ исправления. Если факта нет в доступных источниках,
его нельзя выдавать за подтверждённый.

Предложи готовую правку, но пока не изменяй skill.
Посмотрите, что именно агент собирается добавить. Если предложение подходит, попросите внести его в skill. Отдельную проверку можно выполнять новым запуском того же агента или отдельным проверяющим агентом, если ваша среда это поддерживает. Anthropic описывает похожий процесс: один вызов готовит результат, другой оценивает его и возвращает замечания.
Например, проверяющий видит фразу «инструмент ускоряет работу в два раза», а в источнике такой цифры нет. Он возвращает конкретное замечание, после чего автор убирает цифру или ищет подтверждение. Это улучшает текущий пост. Чтобы учиться на таких случаях, понадобится следующий шаг.
Шаг 2. Сохраняйте ошибки и исправления
Попросите агента после каждого поста сохранять короткую запись, например в feedback.md:
Материал: пост о новом инструменте
Проблема: в источнике не было цифры об экономии времени
Исправление: удалили цифру; оставили подтверждённое описание
Причина: существенный факт без подтверждения
Если вы сами изменили текст, добавьте причину правки или попросите агента сравнить версии и предложить возможные причины — затем проверьте его выводы. Разница между черновиком и итогом показывает, что изменилось; без вашего комментария агент может неправильно угадать, почему.
Если вы ещё не публикуете посты и не даёте обратную связь, агент всё равно может накапливать ошибки, найденные его проверками. Но это будет сигнал внутренней проверки: он не покажет, понравился ли текст аудитории или стал ли полезнее в работе.
Шаг 3. Поручите агенту улучшать skill
Когда накопится несколько записей, запустите отдельную задачу:
Прочитай мой skill для Telegram-постов и feedback.md.
Найди одну ошибку, которая повторяется в нескольких материалах.
Покажи примеры и предложи небольшое изменение skill,
которое может её уменьшить.

Сохрани полную копию skill и нужных ему файлов в папку
improvement/baseline/, а вариант с правкой — в improvement/candidate/.
Держи их вне папок автоматического обнаружения skills.
Не заменяй рабочую версию. Подготовь задания для проверки
обеих версий на примерах, которые не использовал для правки.
Для каждого задания укажи путь к соответствующей копии.
Предложи оценивать подтверждённость фактов, полезность,
понятность и новые ошибки.

Сохрани отчёт: что предлагаешь изменить, почему и какие
задания нужны для сравнения. Не публикуй посты и не меняй
рабочий skill.
На выходе вы получите гипотезу: какую ошибку агент заметил, какое правило предлагает и как его можно проверить. Результаты сравнения появятся после следующих запусков.
Для сравнения подготовьте несколько коротких брифов, включая случай, где источник не содержит нужного факта. Запустите два отдельных чата или задания: в одном явно попросите использовать только копию improvement/baseline/, в другом — improvement/candidate/ и их собственные вспомогательные файлы. Не вызывайте установленный skill по имени: иначе агент может выбрать действующую версию. Попросите записать использованный путь и хеш файлов. Пусть обе версии выполняют одинаковые задания с одинаковым доступом к источникам. Сохраняйте результаты отдельно. Если вы использовали эти примеры для доработки правила, для следующей независимой проверки потребуются новые.
После двух прогонов попросите агента сопоставить сохранённые результаты по заранее заданным критериям, указать ошибки обеих версий и подготовить итоговый отчёт. Если хотя бы один прогон не завершился, оставьте сравнение незавершённым.
Небольшой набор поможет заметить явное ухудшение, но не докажет стабильный рост. Агент может хорошо пройти знакомые тесты и ошибиться на новой теме. Поэтому полезно сохранять не только итоговую оценку, но и сами тексты, замечания и стоимость или время выполнения. OpenAI рекомендует проверять skills на наборе разных задач, а не полагаться только на одно удачное выполнение.
Как сделать цикл автономным
Сначала запустите описанные шаги вручную и посмотрите, даёт ли журнал полезные замечания. Затем можно связать их в регулярный процесс. Один из простых вариантов — проверять журнал раз в неделю, а не пытаться реагировать на каждую новую запись.
Сначала добавьте в рабочий skill завершающий шаг: после поста выполнить проверку, сохранить черновик и исправления, а затем добавить одну запись с уникальным номером материала в feedback.md. Если проверка не выполнена или источник недоступен, записать проблему и оставить материал на проверке. Этот шаг действует при запуске skill; сам по себе он не запускает агента.
Затем создайте отдельную задачу по расписанию, которая получает доступ к тому же skill, журналу и тестовым примерам. Можно использовать такой текст:
Раз в неделю проверяй feedback.md и журнал предыдущих разборов.
Если есть кандидат со статусом «проверка не завершена»,
сообщи об этом и не создавай новый. Иначе, если после последнего
завершённого разбора меньше трёх новых материалов, запиши
«недостаточно данных» и закончи. При трёх или более материалах
найди повторяющуюся ошибку, создай отдельного кандидата skill
и задания для сравнения. Сохрани пути, номера материалов и
статус «проверка не завершена». Меняй статус на «завершена»
только после анализа результатов обоих прогонов. Если источники
или проверка недоступны,
зафиксируй ошибку и остановись. Рабочий skill не изменяй,
материалы не публикуй и сообщения не отправляй.
Число три здесь — стартовый порог для примера, а не статистическое доказательство. Зафиксируйте порядок сравнения и критерии до запуска задачи. Для пропущенных, прерванных или повторных запусков проверяйте журнал и исключайте повторную обработку тех же номеров.
В Codex создайте автоматизацию в приложении для нужного проекта и задайте ей этот текст и еженедельное расписание; убедитесь, что выбранная среда видит файлы и сохраняет результаты. В Claude Code можно использовать запланированную задачу: выбрать репозиторий, расписание и вставить текст. Облачный запуск работает с доступной ему копией репозитория и подключениями, а не автоматически с файлами на вашем компьютере; результаты нужно просматривать и переносить в рабочую версию. Доступность расписаний и окружение зависят от настройки аккаунта. Перед регулярным запуском проверьте один прогон и права на чтение и запись.
Такой процесс автоматически готовит кандидата и отчёт. Два отдельных сравнения пока запускаете вы, а итоги передаёте агенту на разбор. Чтобы и сравнение запускалось само, нужен отдельный оркестратор: он должен стартовать два независимых запуска с явными путями к версиям, дождаться результатов и передать их проверяющему. Это отдельная настройка, а не следствие текста расписания.
Для повторных запусков журнал постов и номера уже обработанных материалов должны храниться постоянно и быть доступны следующему запуску. Например, при локальной автоматизации это могут быть файлы проекта с подходящими разрешениями. Облачная задача Claude Code начинает работу со свежей копии репозитория: файлы, оставшиеся только внутри прошлого запуска, она не увидит. Нужны общее подключённое хранилище с разрешением на запись или перенос результатов в доступную следующему запуску ветку. Если перенос выполняете вручную, цикл работает автономно только до этого шага.
Даже при работающем расписании нет гарантии, что проверяющий верно оценил качество, а изменение улучшит будущие посты.
Возможны два уровня самостоятельности:
Агент предлагает изменения. Он сам проверяет материалы, ведёт журнал и готовит кандидата. В описанном варианте вы запускаете два сравнения, затем агент готовит итоговый отчёт. Вы решаете, заменить ли рабочий skill. Это наиболее простой первый вариант.
Система сама принимает ограниченные изменения. Для этого нужно отдельно построить процесс, который запускает проверки, сравнивает результаты по заранее заданным условиям, сохраняет версии и умеет откатить неудачное изменение. Если данных недостаточно, проверка не завершилась или найден критический сбой, система оставляет прежнюю версию. Само наличие текста в skill или расписания такую инфраструктуру не создаёт.
Автоматически проверять можно, например, наличие ссылки, соответствие формату или отсутствие ранее обнаруженной ошибки на наборе примеров. А вот действительно ли ссылка подтверждает вывод, хорошо ли написан текст и правильно ли вы поняли аудиторию, часто требуют более сложной проверки. Модель-судья может помочь, но её оценки тоже нужно периодически сверять с источниками и реальными примерами.
Разрешения определяются настройками вашей среды. Имеет смысл дать агенту доступ к рабочим материалам и черновикам, а публикацию и внешние действия подключать отдельно, когда вы готовы к этому. Настройка цикла улучшения сама по себе не означает, что вы поручили агенту публиковать материалы.
Что ещё можно улучшать кроме текста skill
Иногда ошибка находится не в инструкции. Агент может получать устаревший источник, пропускать архив предыдущих постов или не видеть ваши исправления. В таком случае полезнее изменить доступ к данным или порядок проверки, чем добавлять ещё одно правило в SKILL.md.
Условный пример: посты постоянно повторяют уже опубликованные темы. Можно добавить шаг поиска по архиву перед написанием. Затем проверить на новых идеях, находит ли агент действительно похожие материалы и не отклоняет ли свежие темы только из-за совпадения слов.
Изменения стоит вносить по одному: тогда проще понять, помогло ли новое правило. Храните предыдущую версию, фиксируйте основание правки и не позволяйте агенту менять критерии оценки ради лучшего результата.
Где брать настоящую обратную связь
Самая доступная обратная связь — ваши действия: что вы исправили, удалили или вернули агенту. Когда процесс уже работает, можно подключить дополнительные сигналы: редакторские оценки, комментарии читателей, статистику постов и результаты переходов. Важно сохранять контекст: тема, канал, дата и способ распространения влияют на результат вместе с качеством текста.
Есть опубликованные примеры подобных циклов. Авторы образовательной контент-фабрики описали систему, которая учитывает реакцию аудитории при настройке правил следующих материалов. По их данным, за пять месяцев было выпущено 26 руководств. Это описание самих авторов, с ограниченной выборкой; такой результат нельзя автоматически перенести на другой блог.
В кейсе Assembled исправления операторов поддержки используются для анализа ответов ИИ. Для одного клиента сообщается о росте точности с 62% до 90%, но опубликованных подробностей недостаточно, чтобы приписать весь эффект одному механизму или обещать повторение результата.
Начните с одного skill и одной повторяющейся ошибки. Добавьте проверку текущего результата, сохраните несколько наблюдений и поручите агенту предложить первую правку. Когда увидите, что сравнение даёт полезные выводы, решите, какую часть цикла автоматизировать дальше.
Похожие статьи
MCP в Тильде: как подключить AI-агента и поручить ему правки сайта
Официальный MCP-сервер Тильды: возможности, подключение, права доступа и три примера заданий для страниц, Потоков и Каталога.
Dots в ChatGPT: как запустить, настроить и использовать постоянного AI-помощника
Подробная инструкция по Dots: доступность, установка ChatGPT, приложения, расписания, память, контроль действий, стоимость и пять полезных сценариев.
AI для нетехнической команды: ценность появляется после передачи результата в процесс
Почему доступ к AI не равен внедрению и как связать результат агента со следующим рабочим шагом, проверкой и метрикой.